Enterprise Context: một nguồn sự thật (SSOT) thay cho các công cụ AI rời rạc
Cách xây dựng két tri thức tập trung Single Source of Truth (SSOT) bằng Markdown và Obsidian, giải quyết triệt để phân mảnh dữ liệu và hallucination trong AI.
TL;DR: Cho nhân viên sử dụng ChatGPT hay Claude một cách tự phát tạo ra tình trạng "silo ngữ cảnh", làm rò rỉ dữ liệu và tăng nguy cơ ảo giác (hallucination). Xây dựng một két tri thức tập trung Single Source of Truth (SSOT) dựa trên định dạng Markdown phẳng kết hợp hệ thống cấp phát ngữ cảnh động (Context Engine) là nền tảng cốt lõi giúp các AI Agent vận hành đồng nhất, chính xác và có thể kiểm toán.
Trong hầu hết các doanh nghiệp hiện nay, việc "ứng dụng AI" thường bắt đầu bằng cách mua tài khoản ChatGPT Plus hay Claude Pro cho từng nhân viên. Trưởng phòng marketing dùng một khung chat riêng, nhân viên chăm sóc khách hàng dùng một tài khoản khác, và lập trình viên lại lưu prompt trên máy tính cá nhân.
Bề ngoài, mọi người đều tỏ ra bận rộn và có vẻ năng suất hơn. Nhưng nhìn từ góc độ kiến trúc hệ thống, doanh nghiệp đang tự tạo ra một thảm họa quản trị: Sự phân mảnh ngữ cảnh doanh nghiệp (Enterprise Context Fragmentation).
Mỗi mô hình AI chỉ thông minh bằng lượng ngữ cảnh (Context) mà nó được cung cấp tại thời điểm truy vấn. Khi ngữ cảnh bị phân tán thành hàng chục mảnh vụn không kiểm soát, các câu trả lời mà AI đưa ra cho khách hàng sẽ bắt đầu mâu thuẫn lẫn nhau, dẫn đến những sai lệch nghiêm trọng về chính sách giá, cam kết dịch vụ và uy tín thương hiệu.
Nỗi đau khi AI vận hành bằng các "hòn đảo tri thức" rời rạc
Vấn đề lớn nhất của các mô hình ngôn ngữ lớn (LLM) không phải là khả năng suy luận, mà là hiện tượng ảo giác khi thiếu dữ liệu nguồn đáng tin cậy.
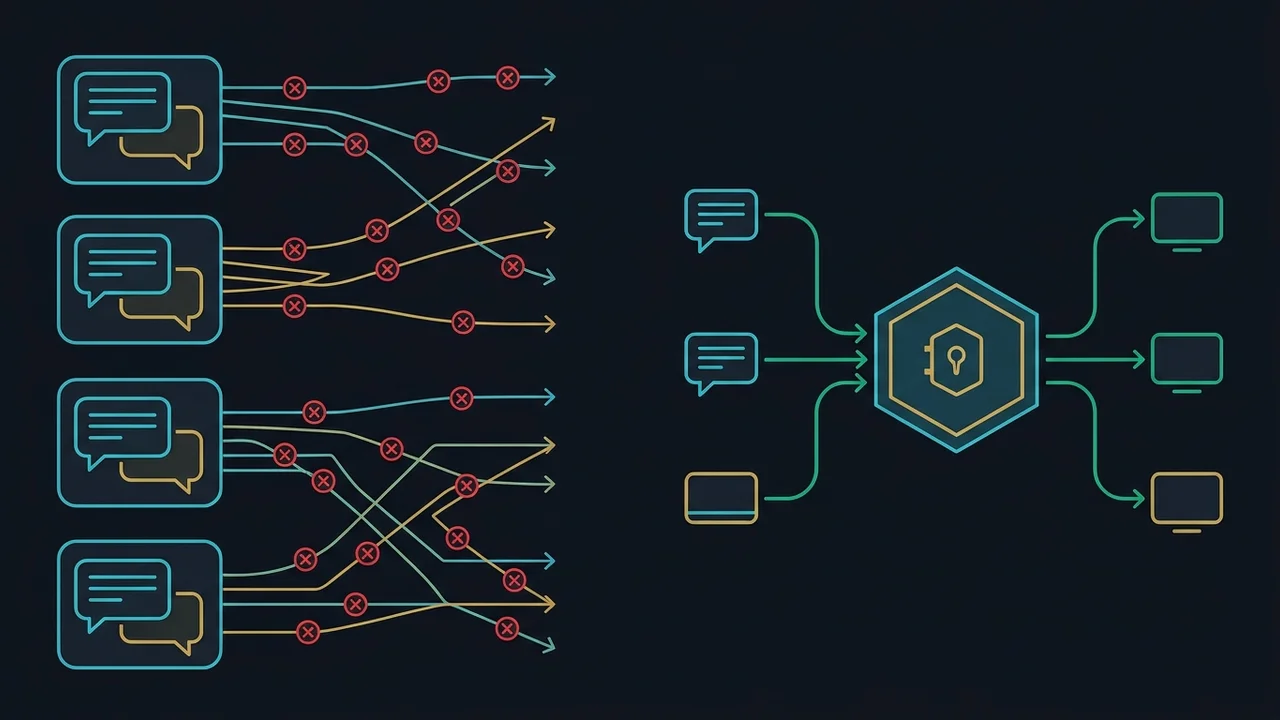
Khi không có một nguồn dữ liệu duy nhất làm chuẩn (Single Source of Truth), doanh nghiệp sẽ gặp phải ba điểm nghẽn chí tử:
- Dữ liệu mâu thuẫn giữa các phòng ban: Nhân viên sales dùng AI tư vấn chính sách khuyến mãi cũ từ tháng trước, trong khi đội kỹ thuật dùng tài liệu sản phẩm mới cập nhật tuần này. AI không có lỗi; lỗi là nó được nạp hai mảnh ngữ cảnh trái ngược nhau.
- Tri thức bay màu khi nhân sự nghỉ việc: Toàn bộ kinh nghiệm xử lý khiếu nại, các mẫu prompt đắt giá nằm trọn trong lịch sử chat cá nhân của nhân viên. Khi người đó rời đi, doanh nghiệp phải bắt đầu lại từ con số không.
- Chi phí token bị lãng phí do nhồi nhét tài liệu: Nhân viên thường sao chép toàn bộ file PDF hoặc bảng tính dung lượng lớn ném vào khung chat. Điều này vừa làm tràn cửa sổ ngữ cảnh (Context Window), vừa làm tăng chi phí API theo cấp số nhân mà chất lượng câu trả lời lại giảm sút.
Kiến trúc SSOT bằng Markdown: Đơn giản, bền vững và chống khóa nhà cung cấp
Nhiều chuyên gia công nghệ khuyên doanh nghiệp nên đầu tư các hệ thống cơ sở dữ liệu Vector đắt đỏ, phần mềm Enterprise Wiki phức tạp hoặc các giải pháp SaaS đóng gói. Nhưng kinh nghiệm thực chiến của tôi cho thấy: công cụ càng cồng kềnh, tỷ lệ thất bại càng cao.
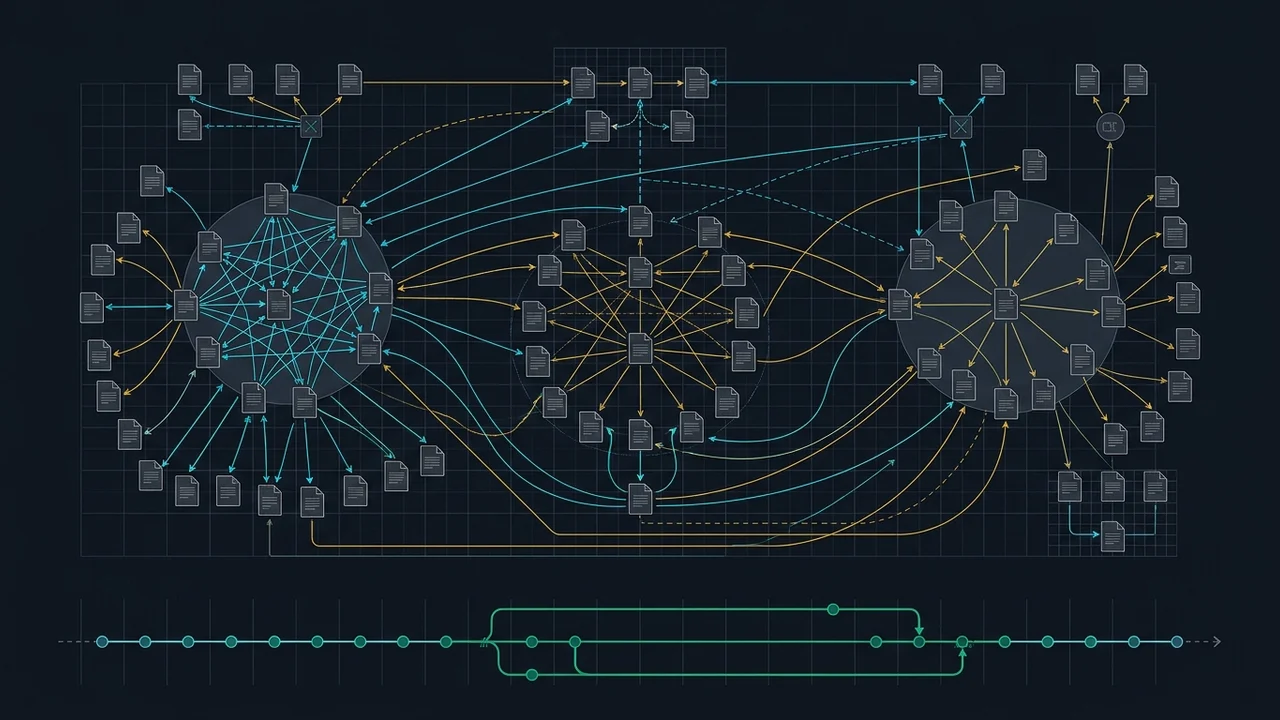
Giải pháp bền vững nhất trong 10 năm tới là đưa toàn bộ tri thức doanh nghiệp về định dạng văn bản thuần túy (Plain Markdown), được tổ chức trong một Obsidian Vault hoặc Git Repository duy nhất:
- Tính trường tồn (Future-proof): Định dạng
.mdkhông phụ thuộc vào bất kỳ công ty phần mềm nào. Cho dù 5 năm nữa OpenAI có đổi giao diện hay một mô hình mới ra đời, file text vẫn luôn được đọc và xử lý dễ dàng. - Dễ dàng kiểm soát phiên bản (Version Control): Mọi thay đổi trong chính sách giá hay quy trình vận hành đều được lưu lịch sử qua Git commit. Bạn luôn biết ai đã sửa điều khoản nào, vào lúc nào và vì lý do gì.
- Liên kết hai chiều (Bidirectional Linking): Mô hình hóa tri thức thành một đồ thị mạng lưới (Knowledge Graph), giúp liên kết tự nhiên giữa "Chính sách đổi trả" với "Sản phẩm A" và "Kịch bản hoàn tiền".
Khi toàn bộ quy trình, biểu phí và tiêu chuẩn nghiệp vụ được quy tụ về một thư mục Markdown duy nhất, bạn đã hoàn thành bước quan trọng nhất: tạo ra Két Tri Thức SSOT (Single Source of Truth) cho toàn bộ tổ chức.
Pipeline cấp phát ngữ cảnh động: Từ SSOT đến Agent thực thi
Có két tri thức là điều kiện cần. Điều kiện đủ là phải có một cơ chế lọc và cấp phát ngữ cảnh chính xác (Context Engine) trước khi gửi prompt đến LLM.
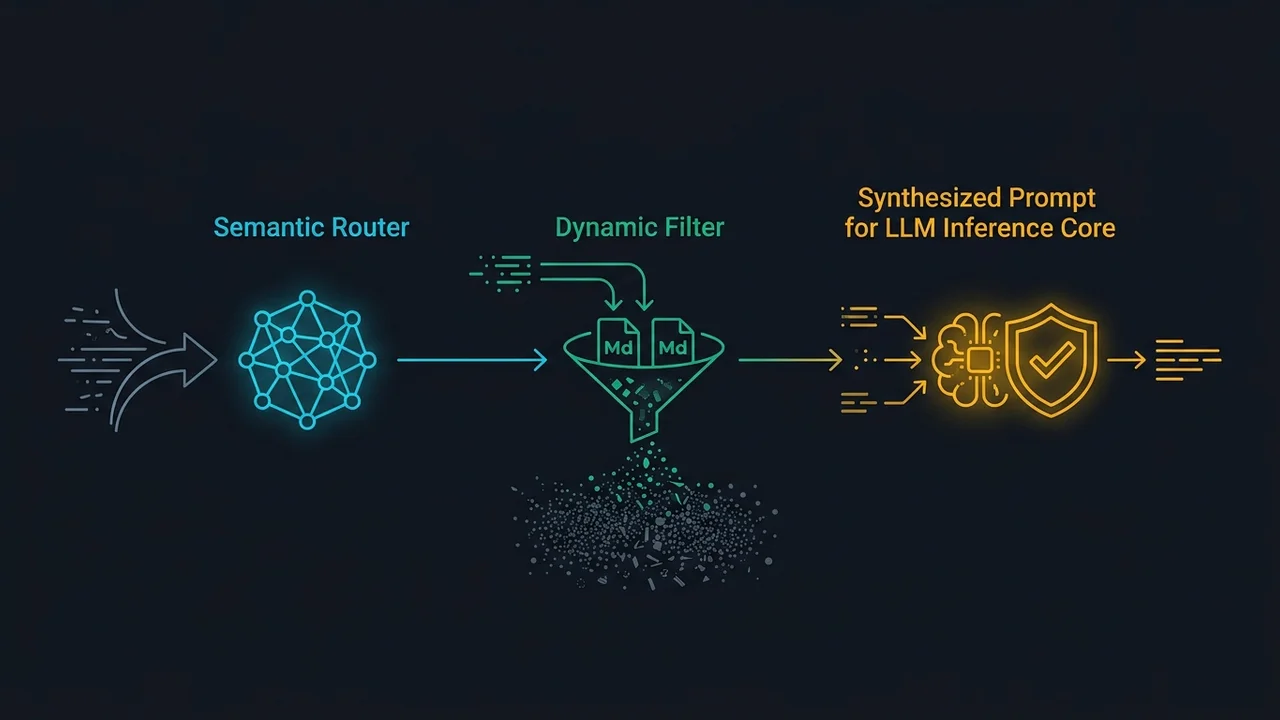
Thay vì nhồi toàn bộ tài liệu 100 trang vào prompt, hệ thống tự động hóa của chúng tôi vận hành theo quy trình 3 nhịp tinh gọn:
[Yêu cầu từ Khách hàng / Nhân sự]
               │
               ▼
┌──────────────────────────────────────────────┐
│  BƯỚC 1: Semantic Router (Bộ định tuyến)     │
│  Phân loại ý định: Hỏi giá / Kỹ thuật / CSKH │
└──────────────────────┬───────────────────────┘
                       │
                       ▼
┌──────────────────────────────────────────────┐
│  BƯỚC 2: Context Retrieval (Trích xuất SSOT) │
│  Chỉ lấy đúng 2–3 file Markdown liên quan    │
└──────────────────────┬───────────────────────┘
                       │
                       ▼
┌──────────────────────────────────────────────┐
│  BƯỚC 3: Prompt Synthesis & Execution        │
│  LLM trả lời dựa trên dữ liệu thật đã xác minh│
└──────────────────────────────────────────────┘
Cách làm này mang lại ba lợi ích đột phá:
- Triệt tiêu ảo giác: AI được yêu cầu rõ ràng: "Chỉ trả lời dựa trên ngữ cảnh được cung cấp. Nếu trong tài liệu không có thông tin, hãy trả lời trung thực là chưa có dữ liệu và đề xuất kết nối nhân sự hỗ trợ".
- Cắt giảm 80% chi phí token: Thay vì gửi 50.000 token tài liệu mỗi lượt gọi, hệ thống chỉ tiêu tốn 1.500 đến 2.000 token cho đúng đoạn trích dẫn liên quan.
- Cập nhật tức thì: Khi bạn sửa giá trong file Markdown trên máy chủ, toàn bộ các AI Agent từ chatbot website, trợ lý Zalo đến công cụ soạn thảo hợp đồng tự động đều ngay lập tức áp dụng biểu giá mới mà không cần huấn luyện lại bất kỳ mô hình nào.
Để tìm hiểu sâu hơn về cách liên kết két tri thức cá nhân thành hệ thống kinh doanh tự vận hành, bạn có thể tham khảo Kiến trúc One-Person Company.
Bắt đầu chuẩn hóa Enterprise Context ngay hôm nay
Đừng đợi đến khi doanh nghiệp có hàng chục nhân sự mới bắt đầu dọn dẹp dữ liệu. Hãy khởi động từ những tài liệu cơ bản nhất:
- Tạo một thư mục
01_BUSINESS_RULESchứa các quy định bất di bất dịch về thanh toán, chiết khấu và hoàn tiền. - Tạo thư mục
02_PRODUCTSmô tả tính năng, thông số kỹ thuật và câu hỏi thường gặp của từng sản phẩm dưới dạng câu hỏi trực diện. - Đặt quy định nghiêm ngặt: mọi nhân viên khi phát hiện dữ liệu sai lệch phải sửa trực tiếp trên file Markdown gốc, thay vì chỉ sửa trong câu trả lời tạm thời của khung chat.
Nếu bạn đang gặp khó khăn trong việc kết nối dữ liệu phân tán của công ty vào các pipeline tự động hóa, hãy đăng ký một buổi Audit Hệ Thống AI Chuyên Sâu 1:1 cùng Tùng để cùng thiết kế bản vẽ kiến trúc SSOT phù hợp nhất với mô hình kinh doanh của bạn.
Câu hỏi thường gặp
Doanh nghiệp nhỏ chưa dùng Obsidian thì có làm SSOT được không?
Hoàn toàn được. Bản chất của SSOT là dữ liệu văn bản thuần túy được tổ chức khoa học. Bạn có thể bắt đầu bằng một kho lưu trữ Git trên GitHub hoặc thậm chí là một thư mục Google Docs có phân quyền chặt chẽ. Tuy nhiên, Obsidian kết hợp Markdown cục bộ mang lại tốc độ truy xuất nhanh hơn và tính riêng tư dữ liệu cao nhất cho doanh nghiệp.
Sự khác biệt giữa SSOT Markdown và cơ sở dữ liệu Vector RAG là gì?
SSOT Markdown là tầng lưu trữ tri thức gốc do con người viết và xác thực (Ground Truth). Còn Vector Database chỉ là một công cụ lập chỉ mục (index) kỹ thuật số để máy tính tìm kiếm các đoạn văn bản tương đồng. Nếu văn bản gốc trong SSOT bị sai hoặc lỗi thời, việc dùng Vector RAG hiện đại đến đâu cũng chỉ tạo ra những câu trả lời sai lệch nhanh hơn mà thôi.
Làm thế nào để bảo mật tài liệu nội bộ nhạy cảm trong két tri thức?
Chúng tôi phân tách két tri thức thành các phân khu rõ ràng: Public Context (tài liệu sản phẩm, chính sách mở cho chatbot tiếp cận) và Internal Core (bí mật kinh doanh, báo cáo tài chính chỉ cho phép Agent nội bộ truy cập qua mạng riêng ảo và yêu cầu xác thực hai lớp).
Nhận Bộ Thư Viện Prompt & SOP AI Workflow Vận Hành Doanh Nghiệp 2026
Tặng miễn phí Ebook PDF + Notion Template quản lý AI System thực chiến từ Tôi Là Tùng. Gửi trực tiếp vào hòm thư công việc của bạn.
Sở Hữu Lexi AI Autopilot — Hệ Thống Multi-Agent Marketing & Sales
Bộ mã nguồn tự động hóa quy trình marketing/sales bằng nhiều AI Agent phối hợp — chỉ 45.000đ, kèm bonus trị giá 1.5 triệu đồng.
Bài Liên Quan
Bộ nhớ AI Agent: xử lý tri thức cũ trước khi trả lời
GraphRAG vs Obsidian: bộ nhớ AI Agent khác bộ não bạn
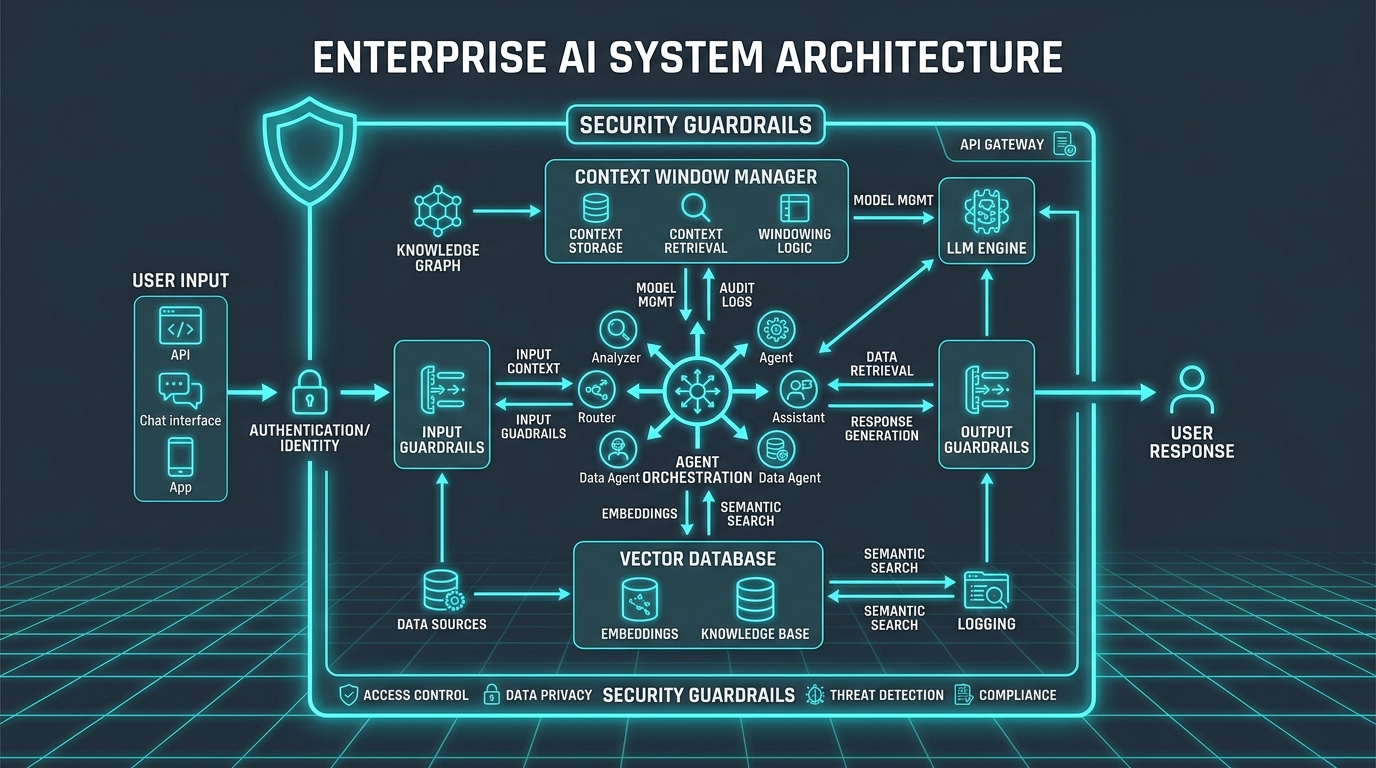
Hạ Tầng AI Architecture 2026: 4 Trụ Cột Scale Hệ Thống Tinh Gọn
6 Hệ Thống Agent Tự Trị Vận Hành Tri Thức Obsidian
Thiết Lập Lớp Phiên Dịch Cho Obsidian Tránh Tràn Context
Triết Lý LLM-Wiki: Biến Obsidian Thành IDE Cho AI Agent
Khóa học & Công cụ gợi ý
Lộ trình học
- Claude MasterclassTối ưu context window, custom instructions và kỹ thuật điều khiển Claude.
- Vibe Coding — Làm Chủ AI Để CodeBuild, deploy và vận hành sản phẩm AI thật bằng Claude Code và tư duy Director.
- AI Coaching & SME OptimizationAudit quy trình và thiết kế Agentic Workflow riêng cho doanh nghiệp SME.
Công cụ tự triển khai
- Autonomous Multi-Agent B2B Marketing & Sales Autopilot (Lexi AI System)SOP & Blueprint tự động hóa 90% phễu Marketing & Bán hàng B2B tích hợp ManyChat, Slack, Telegram và Trợ lý tự trị Manus AI.45.000đ
- n8n Automated Marketing Ops AgentBlueprint đồng bộ tự động dữ liệu lead từ chatbot ManyChat về Notion CRM đã được làm sạch và tối giản.45.000đ
- LexiKeyFlow macOS Voice Input AppỨng dụng macOS giúp nhập liệu bằng giọng nói (Hold-to-Talk) kết hợp Whisper Local dịch offline và Gemini AI mài giũa văn bản.45.000đ